Свободные руки

Нейросети на службе у взломщиков — сюжет не первый год. Обычно речь о подсказках: модель сочиняет фишинговое письмо, разбирает найденную уязвимость, латает чужой код. Решение всё равно принимает человек за клавиатурой. 2 ноября Positive Technologies описала инцидент, который в эту картину не укладывается.
Разбор провёл PT ESC IR, департамент реагирования на инциденты. Речь об успешной атаке на одну российскую компанию, которую, по оценке специалистов, полностью провели ИИ-агенты. Агент в таком разборе — программа поверх языковой модели: шаг за шагом она решает сама, отдаёт команды и разбирает, что вернулось.
Самое важное в четырёх пунктах
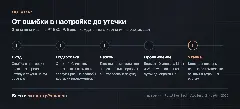
- Что случилось. Точка входа — неверная настройка внешнего сервиса. За три часа атакующие прошли больше чем десять узлов на Linux и Windows, а из внутренних систем ушли конфиденциальные данные.
- Почему решили, что это ИИ. Скорость машины, десятки свежих скриптов с паузой в секунды, параллельный перебор вариантов и россыпь мелких промахов, которые тут же правились.
- Чего мы не знаем. Компанию, её отрасль, модель под агентами и то, был ли рядом человек. Полную автономность PT прямо не подтверждает.
- Почему это важно. Три часа — меньше, чем у многих компаний уходит на реакцию по первому оповещению. Атака в машинном темпе финиширует раньше, чем дежурный успеет её разглядеть.
В сеть попали через неверную настройку внешнего сервиса
Как сообщает PT ESC IR, первый доступ атакующие получили из-за неверной настройки внешнего сервиса. Такую оплошность, отдельно подчёркивают специалисты, вручную заметить непросто. Что это был за сервис и какой параметр оказался не тем, в компании не раскрывают.
Дальше события понеслись. Несколько серверов почти в один и тот же момент получили десятки свежих скриптов. Библиотеки и программные компоненты ставились, окружение подгонялось под себя, инструменты пробовали затащить на машины разными путями. То, что не срабатывало, переделывали по ходу, а не откладывали до следующего захода.
Итог: доступ больше чем к десяти узлам корпоративной сети, среди них серверы на Linux и Windows. Задача, судя по всему, одна: забрать конфиденциальные данные из внутренних систем. Между первым проникновением и утечкой — около трёх часов.
Денис Гойденко, руководитель PT ESC IR, в беседе с «Газете.Ru» напомнил: экспериментальные атаки с ИИ уже фиксировались, а злоумышленники давно берут его на отдельные этапы. Но в практике PT ESC IR подобное встретилось впервые: успешная атака затронула машины под Linux и Windows, и всё указывает на то, что её целиком провели ИИ-агенты, об этом говорят скорость и характер действий.
Машину выдают темп, ошибки и шум
Ярлыка «здесь работала нейросеть» в журналах не бывает. Вывод строят по почерку, а у агента он не такой, как у человека.
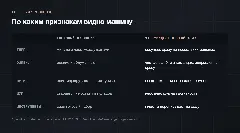
Темп. Прежде чем сделать шаг, человек размышляет, разбирает вывод прошлой команды и подбирает инструмент. У агента свежие скрипты и команды сыпались с промежутком в секунды, причём сразу на нескольких машинах. Расследователи и зацепились в первую очередь за небывалую скорость и плотность действий за короткое время.
Ошибки. Синтаксис команд и имена компонентов у атакующих сбоили регулярно, однако вслед за промахом почти мгновенно шла правленая команда либо иной подход. Опытный оператор до такого не доходит, а новичок не чинится с подобной прытью. Для языковой модели это норма: почти верную команду она выдаёт уверенно, получает отказ и сразу правит.
Перебор. Продвигаться по сети агент пытался сразу несколькими путями. Человек обычно выбирает одну дорогу и сворачивает с неё, лишь наткнувшись на стену.
Шум. Кто взламывает давно, тот держится тихо. Тут картина обратная: активности было непривычно много, ведь агенту важнее успеть к цели, чем замести следы. Отдельные шаги, если верить PT, с точки зрения человека вообще не имели смысла.
Инструменты на ходу. Группировку обычно опознают по собственному набору программ. В этом инциденте утилиты рождались и переделывались по ходу атаки, так что связать её с конкретной группой намного сложнее.
PT не подтверждает, что атака шла без человека
Разгонять новость сильнее, чем она того стоит, не надо. В заголовках СМИ пишут «ИИ впервые взломал компанию», а сама PT формулирует аккуратнее.
Участие ИИ-агентов остаётся выводом по совокупности следов, а не доказанным фактом. Что операцию провели одни агенты, без человека за пультом, окончательно подтвердить пока не удалось. Первой в мире автономной атакой ИИ этот случай PT тоже не называет, это первый такой пример в её собственной практике. Компания, отрасль и модель, на которой работали агенты, не названы.
Читать новость правильнее так: российские специалисты впервые столкнулись в реальном инциденте с атакой, которая по всем признакам шла в манере и темпе машины.
Похожие случаи уже были, но полной автономии пока мало
Годом раньше, в ноябре 2025-го, Anthropic описала кампанию кибершпионажа с участием своей модели Claude. По оценке компании, ИИ тогда закрыл 80–90 % работы: разведка, поиск уязвимостей, код для взлома, вывод данных. Люди подключались в отдельных точках и одобряли серьёзные решения.
В октябре 2026 года, как пишет SecurityLab, облачная компания Wiz рассказала про атаки, где агент сам находил входные точки, копил учётные данные, ходил между облачными сервисами и переписывал скрипты, спотыкаясь об ошибки. Команды появлялись через интервалы, слишком короткие для ручной работы.
Полностью автономная атака при этом остаётся задачей непростой. На сентябрьских испытаниях Standoff 365 и CyberED из 310 ИИ-агентов полную учебную цепочку прошли 33 — примерно каждый десятый. Прочие застревали, выбирали неудачные маршруты или ждали подсказки от оператора. Но в реальной сети успех не требует, чтобы получалось у всех: хватит одного агента, нашедшего одну ошибку.
Общий фон тоже растёт. По данным PT, в третьем квартале 2026 года у российских компаний стало на 65 % больше событий, где в трафике явно видны следы ИИ. Попытки эксплуатации уязвимостей заняли 5,6 % против 1,1 % кварталом ранее. Чаще прочего там встречаются SQL-инъекции, обход каталогов, внедрение команд операционной системы.
Быстрота агента, а не его ум
Дело вовсе не в превосходстве агента над человеком: здесь он, наоборот, промахивался чаще. Решающий фактор — темп.
Привычная схема обороны построена под человеческую неспешность. Мониторинг выдаёт тревогу, дежурный добирается до неё через полчаса, а то и утром, и ещё около часа тратит на осознание картины. Взломщику из плоти и крови, которому сеть нужно изучать днями, такого запаса хватает. Агенту, который за три часа успевает пройти путь к утечке, — нет: пока тревогу открыли, данные давно ушли.
Гойденко формулирует это так: когда атака развивается без постоянного участия человека, привычного уровня автоматизации уже мало. Защитникам требуются средства, которые с похожей скоростью заметят подозрительную активность, разберут происходящее и помогут атаку прервать. PT такие инструменты продаёт. Но сам вывод от этого вернее не становится.
Фото: U.S. Department of Energy / вычислительный центр Fermilab. Общественное достояние, Wikimedia Commons.
Свои сервисы можно закрыть и без большой команды
Своя крупная служба безопасности есть не у каждой компании. Но часть мер реально внедрить и на единственном сервере, и силами небольшой команды.
- Проверьте всё, что доступно из интернета. Началом атаки стала оплошность в конфигурации сервиса, выставленного наружу. Подобные промахи агент находит и быстрее, и внимательнее человека. Что попадается чаще всего: панель администратора без защиты, база или Redis без пароля, API Docker, видный снаружи, включённая отладка на боевом сайте, каталог
.gitв корне. Пройдитесь по своим адресам сканером снаружи и прикройте лишнее. - Сократите окно реакции. Когда тревоги разбирают раз в сутки, агент завершит дело раньше, чем кто-то их откроет. Для самых тяжёлых событий заведите автоматику: блокировка учётной записи, отключение узла от сети, остановка сервиса.
- Ловите всплески активности. Темп выдаёт агента с головой: десятки свежих процессов за минуту, новые скрипты во временных каталогах, установка пакетов на боевой машине, где руками их не ставят. Нехитрое условие «от одной учётки пришло больше N команд за минуту» срабатывает тут надёжнее замысловатых сигнатур.
- Расставьте приманки. Агент читает подряд всё, что попадётся, и тут же пускает находки в дело. Фальшивый ключ доступа или пароль в неиспользуемом конфиге сработает сигнализацией: как только им кто-то воспользуется, значит, в сети чужой.
- Разделите сеть на сегменты. Если за три часа задеты больше десяти узлов, внутри почти ничто не мешало прыгать с машины на машину. Чем меньше узлов видят друг друга без надобности, тем медленнее развивается атака и тем выше шанс её поймать.
- Уберите секреты из файлов. Пароли в
.env, ключи в истории shell, токены в скриптах: всё это агент выудит за секунды. Держите такое в менеджере секретов и меняйте по расписанию. - Держите журналы отдельно от атакуемых машин. Логи, оставленные на том же сервере, атакующий просто сотрёт. Уводите их на отдельный хост, иначе расследовать будет нечего.
Быстро осмотреть сервер на Linux помогут несколько команд. Расследование они не заменят, зато покажут, не завелось ли на машине чего-то нового.
# Скрипты, изменённые за последние сутки (кроме домашних каталогов)
find / -xdev \( -path /proc -o -path /sys -o -path /home \) -prune -o \ -type f \( -name '*.sh' -o -name '*.py' -o -name '*.pl' \) -mtime -1 -print 2>/dev/null
# Что лежит во временных каталогах, свежее сверху
ls -lat /tmp /var/tmp /dev/shm | head -n 30
# Пакеты, установленные через apt за последние дни
grep -h ' install ' /var/log/dpkg.log | tail -n 20
# Библиотеки Python, появившиеся за три дня
find / -xdev -type d -name '*.dist-info' -mtime -3 2>/dev/null | head -n 20
# Входы по SSH за сутки
journalctl -u ssh -u sshd --since '24 hours ago' | grep -E 'Accepted|Failed' | tail -n 30
Заметили в выводе то, чего сами не ставили и не запускали? Это повод копать глубже, а не сносить находку на месте: для разбора она ещё пригодится.
Дальше будет быстрее, и это уже видно
Пока случай PT единственный, и описан он с оговорками. Однако вектор ясен. Модели пишут и правят код быстрее человека, агенты тянут длинные цепочки действий, а просчёты в конфигурациях сервисов остались на месте. Сойдутся эти три обстоятельства вместе, и на взлом уйдут часы вместо недель.
Радует другое: агенту не требуется ничего изобретать. Ему попадаются те же незакрытые панели, пароли в файлах и плоская сеть, что и человеку, только проделывает он это шустрее. Значит, и оборона держится на прежних скучных вещах, о которых твердят который год. Отличие одно: цена отсрочки выросла.
Источники: сообщение Positive Technologies от 2 ноября 2026 года в пересказе «Газеты.Ru», SecurityLab, Lenta.ru, Life.ru и TRT; комментарий Дениса Гойденко из «Газеты.Ru» и CISOCLUB. Про испытания Standoff и отчёт Wiz писал SecurityLab. Про кампанию с Claude есть отчёт Anthropic, ноябрь 2025 года. Команды проверки я собрал сам, они для Debian и Ubuntu.

В середине лета Anthropic внесла изменение, которого не видно ни в интерфейсе, ни в самих ответах: тексты новых моделей Claude теперь несут метку. Дело не в подписи под текстом и не в скрытых символах, сигнал зашит в том, как модель подбирает слова. Скопируйте ответ в документ, перешлите в чат или выложите в блог, и метка поедет следом. Дальше — о том, что она собой представляет, кому открыта проверка и где границы доверия к ней.
Повод для свежего витка — облака. К 10 ноября раскатка маркировки завершится на Amazon Bedrock, так что она доберётся и до компаний, которые подключают Claude через облако.
Главное сразу
- Что метится. Любой текст, который выдают модели Claude, появившиеся после 2 августа 2026 года: в чате, через API, в Claude Code и в остальных продуктах. Более старые модели подключат позже.
- Как. Слова модель подбирает не совсем случайно: подсказку даёт секретный ключ. Ни невидимых символов, ни добавленных слов в тексте нет.
- Где. Везде в мире, хотя толчком стал европейский закон об ИИ. Ограничить метку одним регионом Anthropic, по своим же словам, пока не может.
- Кто проверяет. Детектор закрыт. Доступ по заявке выдают регуляторам, журналистам, исследователям, школам и вузам. У рядового пользователя способа проверить текст нет.
- Что стирает. Серьёзная правка, пересказ, перевод, смешение с чужим текстом. В коротком фрагменте сигнала почти не остаётся.
- Главная оговорка. Метка говорит, что текст прошёл через Claude, а не что Claude написал. Отсутствие метки тоже ничего не доказывает.
Метку ввели из-за закона
В ЕС работает закон об ИИ: статья 50 обязывает делать контент, созданный нейросетью, распознаваемым для машины. В августе заработал добровольный кодекс о прозрачности, где расписано, как этого добиваться. Под ним стоят подписи Anthropic, Google, Meta, Microsoft, OpenAI и ещё нескольких компаний.
О маркировке стало известно 10–11 августа. Сначала Anthropic выложила справку «Как Claude помечает созданный ИИ контент», а тремя днями позже — материал в блоге с разбором работы текстовой метки. Презентаций и шума не было, поэтому многие о ней так и не слышали.
Как из слов получается метка
Текст языковая модель собирает по фрагменту. Для каждого шага у неё заготовлен перечень продолжений с вероятностями: скажем, «быстро» 30 %, «легко» 25 %, «без труда» 20 % и так далее. Из этого перечня генератор случайных чисел берёт один вариант. Выбор при этом чаще всего действительно случаен.
Водяной знак эту случайность подменяет. Вместо обычного генератора в дело идёт секретный ключ и несколько предыдущих слов: по ним модель решает, каким вариантам отдать небольшое предпочтение. Смысл при этом сохраняется, выбор идёт из подходящих слов.
Зато на длинном тексте копится статистический перекос, которого случайно не бывает. Обладатель ключа его увидит, а без ключа текст ничем не отличается от обычного.
По словам Anthropic, в основе метки лежит подход SynthID-Text. Описала его Google DeepMind в журнале Nature в 2024 году и сразу открыла к нему доступ. Google проверила 20 млн ответов Gemini и не увидела, что помеченные варианты получают от пользователей худшие оценки. Anthropic утверждает то же: ни смысл, ни качество, ни удобство чтения ответа метка не меняет, а сторонних замеров на Claude пока не публиковали.
Устройство метки даёт две заметные детали:
- В фактах и коде след слабее. Если верный ответ один, менять не на что: дату, формулу или название функции синонимом без потери смысла не подменишь. Anthropic прямо признаёт, что во фрагментах с фактами и в коде знак слабее.
- Скрытых символов не появилось. Программа, счищающая пробелы нулевой ширины и другой скрытый мусор, метку не уберёт. Она сидит в самих словах.
Где метка есть, а где её нет
Метка ставится на уровне модели. Значит, она есть в любом продукте, где работает поддерживаемая модель: в приложении Claude, в API, в Claude Code, Cowork и Claude Tag. Если брать Claude через облака AWS, Google Cloud или Microsoft Foundry, текст уходит уже помеченным. На Bedrock раскатка закончится к 10 ноября.
Метка стоит на каждой модели, появившейся 2 августа 2026 года или позже. Старым моделям её обещают добавить позже, без конкретной даты. Оговорка тоже есть: на Sonnet 4.6 и Opus 4.6 метка иногда не срабатывает, если через API передать в запросе другую температуру или иные параметры выборки слов.
С файлами устроено иначе. Картинки, видео и аудио из песочницы Claude для кода получают метаданные с подписью по стандарту C2PA. Внутри файла остаётся запись: «создано или обработано Claude». Форматов много: PNG, JPEG, GIF, WebP, SVG, MP4, MP3 и другие. А PDF, текстовые и офисные документы подписи не получают вовсе.
Устроены C2PA-метаданные проще, чем текстовая метка, и стираются легче. Достаточно сменить формат картинки при пересохранении, сжать её заново или снять скриншот, и подпись пропадёт.
Кто может проверить
Для файлов есть открытый инструмент: Claude Content Checker на сайте claude.com. Он читает метаданные C2PA прямо в браузере, файл никуда не отправляется. Что до самого текста, его этот сервис не смотрит. А детектор, который ищет текстовую метку, для посторонних закрыт.
Anthropic называет его частной предварительной версией и пускает по заявке. В список тех, кому дают доступ, входят регуляторы, правоохранительные органы, СМИ и фактчекеры, независимые исследователи, учебные заведения, общественные организации в ЕС и фирмы, которые прогоняют через детектор свои же материалы, созданные в Claude. Расширить доступ обещают «со временем».
Чего Anthropic не публикует, так это цифр. Ни точность распознавания метки, ни доля ошибок на текстах, написанных людьми, ни объём, после которого ответ можно считать уверенным, не раскрыты. Справка ограничивается оговоркой: если фрагмент очень короткий, сигнала для надёжной проверки не хватит.
Что стирает метку
Копирование и вставку метка переживает, утверждает Anthropic, и «может сохраниться после некоторой правки». Надёжность она теряет, когда текст:
- сильно правили;
- пересказали своими словами;
- перевели на другой язык;
- смешали с другим текстом;
- сократили до пары предложений.
Причина простая: смещение накапливается по всему тексту, и любая переписанная фраза его разбавляет. А перевод подменяет весь словарь разом, так что от метки почти ничего не остаётся.
Как только о маркировке объявили, разработчики начали выкладывать инструменты для её обхода. По сообщению Wired от 19 августа, обходные утилиты пошли в течение нескольких часов после анонса, а одна собрала тысячи звёзд на GitHub. Работают ли они в реальности — никто сторонний не проверял. Невидимые символы, которых, как мы выяснили, в тексте Claude нет, вычищает лишь часть таких программ. Остальные переставляют предложения, подставляют синонимы и прогоняют текст через перевод. То есть делают то, что Anthropic и так перечислила как слабые места.
Выходит, под удар попадают те, кто забирает ответ целиком и ничего не правит. Тот, кто хочет её убрать, уберёт. Инструмент создан под массовый поток текста, а не против тех, кто целенаправленно обходит защиту.
Метка не означает авторство
Самое важное Anthropic пишет в справке без уверток: обнаружив метку, вы узнаёте лишь, что контент «мог быть создан или обработан Claude». И сигнал этот, по её словам, «не окончательный».
Обработка и авторство тут не одно и то же. Скажем, статью вы писали сами, а Claude попросили поправить запятые, сделать перевод или сократить. Тогда в правленом тексте окажутся помеченные фрагменты, и детектор их обнаружит. А автор при этом вы.
В обратную сторону это тоже работает. Отсутствие метки ещё не значит, что перед вами текст человека. Источником могла быть прежняя версия модели Claude, сторонняя нейросеть без маркировки либо открытая модель, никем не помеченная. Мог быть отредактирован или переведён.
У всего этого есть предыстория. The Wall Street Journal в 2024 году отмечал: похожая метка для ChatGPT у OpenAI появилась давно, однако включать её компания не стала. Причина среди прочего в опасении, что детектор начнёт несправедливо бить по тем, кто использует ChatGPT как редактора и для кого английский не родной. Сейчас к маркировке крупных разработчиков подтолкнул закон, а сама проблема никуда не делась.
Что из этого следует
Студентам и преподавателям. Доступ к детектору дают в том числе учебным заведениям. Однако уликой в списывании метка не служит: она появится и на работе, которую студент написал своими руками, а потом отдал Claude на проверку. Для преподавателя это скорее повод поговорить, чем готовый приговор.
Копирайтерам и авторам блогов. Ответ Claude, который вы выкладываете почти без правок, помечен. Удостовериться в этом сегодня способен лишь узкий круг организаций, хотя обещают, что доступ расширят. Ни площадки, ни поисковики пока не заявляли, что читают такую метку. Если у вас в работе схема «модель пишет, человек серьёзно переписывает», от метки уцелеет немного, и это честно показывает, как сделан текст.
Разработчикам. У кода вариантов меньше, поэтому и метка в нём слабее, чем в обычном тексте. Когда ваш продукт выдаёт пользователям тексты из Claude, они помечены. Кроме того, Anthropic советует самому разобраться, какие из требований статьи 50 относятся именно к вашему сервису. Обязанности того, кто встроил метку модели в свой продукт, она не отменяет.
Тем, кто работает с картинками. Проверить подпись C2PA можно бесплатно и без труда, однако любое пересохранение её сбрасывает. Отсутствие подписи у картинок ничего не говорит об их происхождении.
Что в остатке
Это подпись производителя, а не привычный детектор ИИ-текста. Неизменённый ответ модели она находит надёжно, а вот о судьбе текста, побывавшего у человека, в переводе или в другой нейросети, не сообщает ничего. Точность в цифрах не раскрыта, а проверить текст сегодня способен лишь узкий круг организаций.
Для рядового пользователя мало что меняется. Если выкладываете готовый ответ Claude как есть, считайте его подписанным. Когда модель служит вам редактором, переводчиком или собеседником на этапе черновика, метка способна обнаружиться и в тексте, написанном вами. Помнить об этом стоит обеим сторонам: и авторам, и тем, кому предстоит проверять.
Первый российский закон об искусственном интеллекте вступил в силу 1 сентября 2026 года. Речь о Федеральном законе от 26 июля 2026 года № 243-ФЗ «О поддержке развития технологий искусственного интеллекта в Российской Федерации». За полтора месяца в прессе вышло несколько сотен разборов, и добрая их часть пересказывает не тот документ.
Кто-то уверяет, будто контент от нейросетей придётся маркировать в обязательном порядке. Такого требования в тексте нет. Ещё ждут запрета ChatGPT, хотя в законе про него нет ни строчки. У третьих в тексте 675 тысяч: столько за 2025 год набралось «преступлений с дипфейками». На самом деле цифра взята из пояснительной записки к законопроекту, и охватывает она все ИТ-преступления без разбора.
Я прочёл документ полностью и сличил два независимых варианта публикации: расхождений не нашлось. Отдельно посмотрел карточку законопроекта в базе Госдумы, мартовский вариант Минцифры и то, чем он разошёлся с финалом. Плюс два законопроекта, внесённых уже после подписания, вместе с официальными отзывами правительства и Верховного суда.
Подзаконные акты разбираю по материалам «Коммерсанта», «Ведомостей» и ComNews: сами постановления в открытом доступе пока не появились. Всё ниже верно на 17 октября 2026 года. Юристом я не работаю, консультацию этот разбор не заменит. Зато каждую мысль о законе можно сверить по номеру статьи.
Коротко: рамка узкая, маркировка добровольная
- Документ рамочный и охватывает мало что. Под него подпадают только очень крупные модели: от миллиарда параметров, рассчитанные на множество разных задач и годные как база для другого софта. Кредитный скоринг, антифрод, распознавание лиц, небольшие модели остаются вне регулирования.
- Смысловой центр закона, два статуса. Суверенная модель полностью своя и живёт в российских дата-центрах. Национальная тоже принадлежит российской компании, однако собирать её можно на чужих компонентах с открытой лицензией. Любой из статусов приносит преференции от государства, доступ к государственным данным и разрешение учиться на чужих произведениях, не спрашивая автора.
- Маркировка остаётся добровольной. С 1 марта 2027 года большие площадки должны дать пользователю возможность поставить на публикации пометку о том, что её сделал ИИ. Обязанности помечать что-либо у автора при этом нет.
- Наказаний документ не придумывает. Статья про ответственность просто отправляет к уже действующим нормам.
- Основная конкретика начнёт работать 1 марта 2027 года, когда выйдут постановления правительства. Их проекты уже обсуждают: где разрешат применять только российские модели, по каким критериям дадут статус, обязан ли ИИ-помощник стоять на смартфоне по умолчанию.
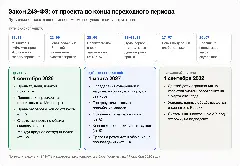
До 243-ФЗ нормы собирали по кускам
Отдельного закона про ИИ до сентября 2026 года не существовало, зато нормы накапливались по частям. Без этой предыстории странно, почему 243-ФЗ вышел таким коротким.
- Национальная стратегия развития ИИ. Появилась указом президента в 2019 году, новая редакция вышла в феврале 2024-го. Именно оттуда в закон пришло определение искусственного интеллекта.
- Экспериментальные правовые режимы. Норма № 258-ФЗ, принятая в 2020 году, даёт право временно отходить от общих правил внутри пилотов. Тогда же отдельным законом стартовал эксперимент с ИИ в Москве.
- Обезличенные персональные данные. С 1 сентября 2025 года их можно прогонять через государственную информационную систему даже без согласия человека, и в том числе ради обучения моделей.
- Кодекс этики в сфере ИИ. Добровольная история 2021 года: подпись под ним поставили крупные игроки отрасли.
- Поручение президента от 1 апреля 2025 года № Пр-706. В пункте 5 предлагалось подумать над тем, признавать ли применение ИИ отягчающим обстоятельством. Подробнее об этом в разделе про ответственность.
Всё перечисленное касалось данных, пилотов и этики. Моделей как объекта права в законах не существовало вплоть до 243-ФЗ.
Первый проект был жёстче: что изменилось до подписи
Минцифры показало первую версию 18 марта 2026 года. Заголовок тогда был другой, и речь в нём шла об основах госрегулирования в сфере применения технологий ИИ. Ввести документ в действие собирались 1 сентября 2027 года. В итоге получился акт про контроль.
В мартовском проекте было:
- три категории моделей: суверенные, национальные и доверенные. Доверенные допускались в государственные информационные системы и на значимые объекты критической информационной инфраструктуры, проходили проверку ФСБ и ФСТЭК и попадали в реестр;
- владелец ИИ-сервиса обязан маркировать созданный контент;
- платформы с суточной аудиторией больше 100 тысяч человек должны были проверять пометки, а при их отсутствии предупреждать автора либо удалять материал;
- разработчик, оператор и владелец сервиса отвечали за оценку рисков, исключение необоснованной дискриминации, тестирование и остановку системы при киберугрозе;
- для ИИ-сервисов с аудиторией больше 500 тысяч человек в сутки действовали требования «закона Яровой» о хранении данных и передаче их силовым структурам;
- все участники цепочки отвечали соразмерно вине, если знали или должны были знать о возможном противоправном результате;
- можно было запрещать или ограничивать трансграничные ИИ-технологии;
- дата-центрам под ИИ давали льготы: подключение к сетям без платы, тарифы на электричество ниже промышленных, долгосрочные договоры с предельной ценой.
В апреле проект раскритиковал Совет при президенте по кодификации и совершенствованию гражданского законодательства. По мнению совета, часть норм расходилась с Гражданским кодексом и расшатывала основы авторского права.
22 июня правительство показало новую редакцию: 13 страниц, 13 статей и нынешнее название. Из неё ушли доверенные модели, реестр, обязательная маркировка, распределение ответственности, ограничения трансграничных моделей и льготы дата-центрам. Вице-премьер Дмитрий Григоренко тогда заявил, что запрета или ограничения доступа к иностранным нейросетям документ не вводит.
Дальше всё пошло быстро. По карточке законопроекта № 1271570-8 в базе Госдумы хронология такая:
- 25 июня 2026 года: законопроект внесло правительство;
- 7 июля: первое чтение в Думе, на поправки дали один день;
- 8 июля: второе и третье чтения;
- 17 июля: одобрение Совета Федерации;
- 26 июля: подпись президента и публикация в тот же день.
Между внесением и подписью прошёл месяц. Ко второму чтению из предмета регулирования убрали слово «использование», оставив «разработку, внедрение и применение». «Набор данных» превратился в «состав данных», «настройка» параметров стала «подбором». Из требований к суверенной модели выпала «матрица исходных коэффициентов», осталось только обучение.
Норму о площадках с кнопкой маркировки переписали: теперь это владельцы сайтов, информационных систем и программ с суточной аудиторией больше 500 тысяч человек, а не владельцы соцсетей. Поправку депутата Михаила Шеремета об упрощённом получении статуса национальной модели для малого и среднего бизнеса отклонили. В третьем чтении «Справедливая Россия» воздержалась.
Вячеслав Володин, председатель Думы, назвал документ рамочным: подзаконные акты пишет правительство, а к основным положениям Дума обещала вернуться до конца года.
Малые модели и узкие сервисы закон не трогает
Предмет регулирования в статье 1 узкий: большие фундаментальные модели ИИ. Закон описывает, как их создают, запускают и применяют, а остального не касается. Определение даётся в пункте 2 статьи 3.
Большая фундаментальная модель это программа для ЭВМ, которая одновременно:
- решает интеллектуальные задачи примерно на человеческом уровне или выше;
- обучена на составах данных, чтобы выявлять закономерности, выдавать информацию, принимать решения или прогнозировать по целям, которые задал человек;
- служит основой для создания и доработки разного программного обеспечения;
- имеет не менее 1 миллиарда параметров;
- применяется для большого количества разных задач.
Признаки нужны все сразу. Модель на 7 миллиардов параметров, которая умеет только читать автомобильные номера, под определение не подходит: задача у неё одна. Универсальная модель на 500 миллионов параметров не подходит по размеру. Кредитный скоринг, антифрод, компьютерное зрение, классификаторы и сценарные чат-боты остаются вне закона. АНО «Цифровая экономика» насчитывала таких моделей в стране несколько десятков.
Разработчиком в тексте закона назван индивидуальный предприниматель или юрлицо, которое проектирует, обучает либо модифицирует модель. Слово «модификация» тут решает многое. Компания, взявшая открытую модель на 8 миллиардов параметров и дообучившая её под свои задачи, по определению становится разработчиком. Правда, обязанности у неё появляются только вместе со статусом.
Пункт 1 статьи 3 даёт определение самого искусственного интеллекта, оно пришло из Национальной стратегии и слегка расширено. Речь о наборе технологических решений, с помощью которого можно имитировать когнитивные функции человека и получать на конкретных задачах результат не хуже человеческого. В скобках закон дописывает три свойства: система сама улучшает свои функции, наращивает точность на новых данных и находит решения без заранее заданного алгоритма. В такой комплекс входят инфраструктура, программы, процессы и сервисы для обработки данных.
Часть 3 статьи 1 выводит под отдельное регулирование оборону и безопасность, оперативно-разыскную деятельность, охрану порядка и безопасность дорожного движения, противодействие отмыванию денег и финансированию терроризма, предотвращение чрезвычайных ситуаций, дипломатию и государственное управление. Специфику там вправе задать другие федеральные законы и акты президента.
Принципы: независимость технологий и традиционные ценности
В статье 4 перечислены девять принципов. Шесть из них никого не удивят:
- благоприятные условия для развития;
- обеспечение прав и свобод человека;
- уважение автономии и свободы воли;
- безопасность;
- международное сотрудничество;
- поддержка российских разработчиков.
Характер документа задают оставшиеся три.
Технологическая независимость. Модели предлагается разрабатывать так, чтобы национальный контроль над критическими и сквозными технологиями сохранялся, а опирались разработчики на собственные линии. Цель двойная: заместить на внутреннем рынке продукцию на устаревших и (или) иностранных технологиях и выйти с этим на экспорт.
Риск-ориентированный подход. Строгость требований к применению модели зависит от того, насколько вероятен вред и насколько он масштабен. В расчёт идут жизнь и здоровье людей, деловая репутация, имущество, окружающая среда, технологическая независимость государства. Ту же логику взял европейский AI Act. Однако классов риска и списка запрещённых применений в российском законе нет. Правительству оставили право вводить отраслевые требования.
Традиционные российские духовно-нравственные ценности. Закон называет их полностью:
- жизнь и достоинство;
- права и свободы человека;
- патриотизм и гражданственность;
- служение Отечеству и ответственность за его судьбу;
- высокие нравственные идеалы;
- крепкая семья и созидательный труд;
- приоритет духовного над материальным;
- гуманизм, милосердие, справедливость;
- коллективизм, взаимопомощь и взаимоуважение;
- историческая память и преемственность поколений;
- единство народов России.
Сам принцип пока ничего никому не предписывает. А в статье 6 он становится условием статуса, и это, пожалуй, одна из самых рабочих норм документа.
Полномочия разошлись по ведомствам
Статья 5 делит полномочия. Национальную стратегию развития ИИ утверждает президент. Правительство координирует ведомства и решает, как поддерживать отрасль. Оно же устанавливает случаи, когда российские модели применять обязательно, и может вводить отраслевые требования по рискам. Если речь о банках и финансовом рынке, оба решения принимают только после согласования с Банком России.
Роль уполномоченного органа по информационным технологиям отдана Минцифры. Министерство смотрит, как развиваются большие модели, готовит предложения по регулированию, помогает госорганам и муниципалитетам запускать их в работу, придумывает меры стимулирования. Проверок, реестра и штрафов у него по этому закону нет.
Госорганы, органы местного самоуправления, госкорпорации и Центробанк ставят большие модели в управление, социальную сферу и основные отрасли, каждый в пределах своих полномочий. Под это написаны цели в статье 2:
- ускоренное внедрение;
- господдержка исследований;
- технологическая независимость;
- эффективность управления;
- конкурентоспособность «на мировом уровне»;
- продвижение российских технологий за рубежом.
Защита пользователей среди целей тоже есть, но в виде общей формулы о безопасности личности, общества и государства.
Два статуса: суверенная и национальная модель
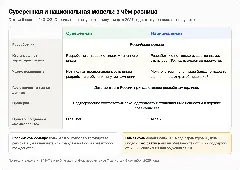
Статья 6 вводит два статуса. Требования почти совпадают, а расходятся в двух пунктах.
Суверенная модель отвечает пяти условиям:
- разработчик — российское юридическое лицо;
- он же задаёт и меняет характеристики модели на всех стадиях жизненного цикла;
- он добивается, чтобы весь цикл разработки, включая обучение, можно было технически и технологически воспроизвести полностью;
- запросы пользователей обрабатываются, а данные лежат в дата-центрах внутри России, которыми владеют российские юрлица;
- соответствие модели российскому законодательству и традиционным ценностям подтверждено в порядке, который установит правительство.
Национальная модель тоже принадлежит российскому юрлицу, тоже живёт в российских дата-центрах и тоже подтверждает соответствие закону и ценностям. Отличия во втором и третьем пунктах. Российская компания сама определяет и меняет лишь существенные характеристики, а перечень даст правительство: настраиваемые параметры, программное обеспечение, структуру. Собирать модель разрешено из компонентов, созданных где угодно, в том числе из чужих больших моделей на условиях открытой лицензии.
Коротко: суверенную обучают с нуля, и одна компания способна воспроизвести её целиком. Национальная может стоять на чужом открытом фундаменте, если структура, код и параметры остаются под контролем российского разработчика.
Российское юрлицо по закону — это компания, которую контролирует государство, регион, муниципалитет или гражданин России без второго гражданства, один или вместе с другими. Контроль значит, что можно прямо или косвенно распоряжаться более чем 50 % голосов. Пока международный договор не говорит иного, компания с иностранным мажоритарием статус не получит, даже если зарегистрирована в Москве и держит серверы в Подмосковье.
Пятый пункт в обоих перечнях стоит разобрать отдельно. Соответствие традиционным российским духовно-нравственным ценностям превращается в условие статуса. Кто станет проверять, по каким критериям и как, закон молчит: порядок установит правительство.
Как вести учёт и присваивать статусы, тоже решит правительство. Статусов на сегодня нет ни одного, и появиться они не могут: определения из частей 2–5 статьи 6 начнут действовать только 1 марта 2027 года.
Официального перечня пока нет
8 сентября «Коммерсантъ» со ссылкой на участников рабочей группы сообщил: под суверенную модель сейчас подходит только GigaChat от Сбера. Alice AI от «Яндекса» газета назвала примером модели национальной.
7 августа то же издание разобрало критерии для национальной модели из ещё не принятого проекта постановления. Разработчику нужны исключительные права:
- на архитектуру и обучаемые параметры, вместе с топологией сети и конфигурационными файлами;
- на код, которым модель обучают и эксплуатируют;
- на настройку контекстного окна.
Всё остальное в модели вправе быть зарубежным, открытым или чужим. Тимофей Воронин, руководитель проектов по аналитике ИИ, оценил, что такие условия оставят за бортом примерно 90 % отечественных компаний и ИИ-стартапов. Большая часть из них работает на открытом коде, так что на статус реально претендовать только крупным экосистемам. Директор по науке и ИИ «Группы Астра» Владимир Нелюб считает статус способом попасть к государственным данным и крупным госконтрактам, а не обязательной приметой рынка. Для небольших языковых моделей статусов не завели вовсе, говорит АНО «Цифровая экономика».
Спорят и о цене. По данным сервиса AIANA, которые приводит «Коммерсантъ», за тысячу токенов GigaChat Max просят 0,65 рубля, за YandexGPT Pro 5.1 просят 0,8 рубля, а открытые модели обходятся в 0,2–0,3 рубля. Сергей Кобелев из «Яков и партнёры» там же заметил, что деньги уходят не на токены, а на запуск, человеческую проверку результата и доработки.
Права разработчика со статусом: поддержка, данные и экспорт
Статья 7 собирает в один перечень права, которые получает разработчик суверенной или национальной модели:
- он может рассчитывать на меры государственной поддержки;
- вправе учить модель на чужих произведениях по правилам статьи 10;
- может входить в отраслевые организации, работать над этическими правилами и предлагать меры для государственной политики в сфере ИИ;
- ему открыто международное сотрудничество, совместные исследования и экспорт технологий;
- может страховать имущественные интересы и ответственность за вред при применении модели.
Ни одной конкретной меры поддержки в законе нет. Определяет их правительство. Полномочия у него по статье 5 широкие:
- финансовые;
- имущественные;
- гарантийные;
- информационные.
Дороже денег здесь другой ресурс, данные. Как открывать составы данных из федеральных информационных систем, систем федеральных унитарных предприятий и учреждений для обучения суверенных и национальных моделей, определит правительство, согласовав порядок с ФСБ. Для своих систем и подконтрольных организаций такие же права есть у регионов. 24 сентября Григоренко отнёс доступ к данным, в том числе государственным, к ключевым вопросам подзаконных актов.
Ещё статья 12: российским гражданам и компаниям нельзя мешать сотрудничать в сфере больших моделей. Исключение сделают только для отдельных значимых направлений, которые определит правительство.
Со сроками у статьи 7 нестыковка. Силу она набрала 1 сентября 2026 года, а определения суверенной и национальной модели появятся лишь 1 марта 2027-го. Полгода права у разработчиков со статусом уже есть, а самих разработчиков со статусом пока нет.
Обязанности есть только у обладателей статуса
Статья 8 занимает мало места. Разработчик суверенной или национальной модели обязан:
- обеспечить модели безопасность организационными и техническими мерами;
- зафиксировать, как модель эксплуатируют, какие есть ограничения и условия применения, как её обновляют и выводят из работы;
- вести техническую документацию: параметры модели и её ограничения описаны там в объёме, достаточном для оценки безопасности применения.
Вступают эти обязанности 1 марта 2027 года и касаются только тех, у кого есть статус. Если статуса нет, закон не предъявляет к разработчику требований, хоть он российский, хоть иностранный. Логика закона прямая: требования работают как условие доступа к господдержке, а не как общее правило рынка.
Маркировка: автору дают право, а площадке оставляют обязанность
Больше всего споров собрала статья 9. Разбирать её проще по частям.
Часть 1. Тому, кто создаёт аудио- или визуальный материал с помощью большой модели, обеспечивают возможность поставить информационное предупреждение о применении технологий искусственного интеллекта. Речь о праве, а не об обязанности. Про тексты здесь не сказано ничего.
Часть 2. Как выглядит предупреждение, что в нём написано и где его размещать, решает соглашение между пользователем модели и тем, кто открывает к ней доступ. На практике это пользовательское соглашение сервиса.
Часть 3. Только здесь возникает настоящая обязанность. Хозяин сайта или отдельной его страницы, информационной системы либо программы должен дать пользователям возможность разместить предупреждение о применении больших моделей, если ресурс одновременно:
- рассчитан на то, чтобы люди распространяли информацию через свои персональные страницы;
- ведётся на русском либо на государственных языках республик и иных языках народов России;
- может показывать рекламу для потребителей в России;
- собирает больше 500 тысяч пользователей из России в сутки.
Признаки те же: персональные страницы, реклама и порог в 500 тысяч пользователей в сутки. По ним Роскомнадзор с 2021 года ведёт реестр социальных сетей по статье 10.6 закона об информации. Туда входят ВКонтакте, Одноклассники, YouTube, Telegram и другие. Прямой отсылки к реестру в законе нет, поэтому точный круг площадок покажет практика.
Расхождение между частями стоит заметить. Часть 1 говорит об аудио и визуальных материалах, часть 3 формулирует шире: про информацию, которую создали большие фундаментальные модели искусственного интеллекта. Буквально выходит, что пометить можно будет и текстовый пост, и площадка обязана такую возможность дать. Что скажут проверяющие, выяснится не раньше марта.
Наказания за отсутствие кнопки не будет, новой статьи в КоАП не появилось. Сила у статьи 9 появится 1 марта 2027 года.
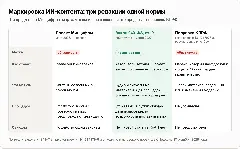
С обязательной маркировкой уже не сложилось
Идея обязательной маркировки в Думе уже проваливалась. Законопроект № 1069302-8 депутатов Дмитрия Гусева, Алексея Журавлёва и Михаила Делягина требовал помечать сгенерированное видео надписью «Сделано ИИ». Профильный комитет 24 апреля рекомендовал документ отклонить, и 10 июня 2026 года Дума так и сделала. Антон Горелкин тогда объяснил, что меру трудно реализовать: авторы не решили, на каком этапе появляется метка и кто виноват, если в ней ошибка.
Вопросы из практики никуда не делись. Метку ставит тот, кто снял ролик, или тот, кто его выложил? Останется ли она, когда файл заново загрузят на другую площадку? И кто всё это проверяет?
Алексей Шпильман из «Т-Технологий» назвал главным не создание метки, а её живучесть. Надпись на картинке несложно обрезать, а водяной знак, которого не видно, уберёт другая модель.
Вторая попытка: поправка № 1317978-8 меняет статью 9 целиком
17 августа 2026 года депутаты КПРФ Нина Останина, Сергей Обухов, Алексей Корниенко и Михаил Матвеев предложили поправку к уже принятому закону. Статью 9 она переписывает полностью, вместе с частью про маркировку.
Заработает поправка 1 марта 2027 года, одновременно с исходной статьёй. Обязанность переходит на сервис, открывающий доступ к модели. Ни автор, ни площадка за метку не отвечают. Ограничений по аудио и видео проект не знает, так что формально метить пришлось бы и текст.
Право пользователя на предупреждение и обязанности площадок из новой редакции исчезают. Ответственности за нарушение проект не вводит.
В пояснительной записке авторы опираются на чужой опыт. Китай с 1 сентября 2025 года требует два уровня маркировки, видимый и скрытый в метаданных. Индия с 20 февраля 2026 года требует от платформ видимой метки на сгенерированных материалах и хранения источника в метаданных. Европейский AI Act ждёт машиночитаемой маркировки.
12 октября Совет Думы отправил законопроект в новый комитет по цифровому развитию и искусственному интеллекту. Отзывы собирают до 11 ноября, а рассмотрение уже стоит в примерной программе на ноябрь.
Обучение моделей и авторское право
Обе части статьи 10 начинают работать 1 марта 2027 года. Первая обращена к любому сервису, который открывает доступ к большой модели, а не к одним лишь обладателям статуса. Такой сервис обязан предупредить пользователя, если закон не говорит об ином, о двух вещах: кому принадлежат права на результаты работы модели и на каких условиях эти результаты можно получить, использовать и сохранять, когда это позволяет техника.
На практике всё сводится к пункту в пользовательском соглашении. Формально норма задевает и зарубежные сервисы, доступные в России, но как её применять к ним, закон не описывает.
Вторая часть делает изъятие из авторского права. Обращение к информации из произведений, включая компьютерное извлечение, сравнение, классификацию, разбор закономерностей, тенденций и корреляций и краткосрочную запись в память компьютера, авторские и смежные права не нарушает. Условий два:
- цель ограничена обучением суверенной или национальной модели;
- разработчик получил экземпляр произведения правомерно либо произведение доведено до всеобщего сведения и доступно для анализа без технических ограничений.
Значит, помешать обучению правообладатель вправе лишь технически: пейволл, логин или другая защита. Записи на сайте тут недостаточно. Закон молчит о том, годится ли в этом качестве robots.txt или машиночитаемая оговорка в духе европейского режима анализа текстов и данных. И платить за такое использование никто не обязан.
Изъятие работает лишь для суверенных и национальных моделей. Остальные разработчики подчиняются общим правилам Гражданского кодекса, где такой нормы нет.
Спор с Гражданским кодексом
Пункт 5 статьи 1229 ГК говорит, что ограничения исключительных прав задаёт сам кодекс. Норма об обучении появилась в отдельном законе, и на это расхождение указала заместитель председателя Совета по кодификации Лидия Михеева.
Правообладатели до второго чтения настаивали на платном обучении или на согласии правообладателя. В итоговом тексте этого нет. Дальше события шли так:
- в конце июля, по данным «Ведомостей», президент поручил подготовить поправки, регулирующие отношения между разработчиками нейросетей и правообладателями;
- Совет по кодификации собрал группу, которая займётся поправками в часть четвёртую ГК; её предложения ждали к концу сентября, а сопредседатель совета Павел Крашенинников сказал: «Нужен баланс, мы попробуем его выстроить»;
- 5 августа правительство создало отдельную рабочую группу по ИИ и авторскому праву для медийной и творческой сфер;
- в обсуждении звучали варианты: прямое лицензирование, коллективное управление правами, отчисления по модели «налога на болванки», который в авторском праве даёт 1 % цены техники и носителей; аналогию предложил зампред ВЭБ.РФ Игорь Дроздов.
Текста поправок в открытом доступе на 17 октября я не нашёл. Депутат Дмитрий Шатунов из нового думского комитета по ИИ назвал авторское право одной из тем доработки закона.
Полная версия: http://bigpanda.mirtesen.ru/blog/43510463046/Zakon-ob-II-v-Rossii-chto-deystvUyet-s-1-sentyabrya-2026-goda-i-
Разберем реальные цены 2026 года — за окно, за створку и за квадратный метр, что входит в работу, почему лоджия обходится дороже трех обычных окон, когда нужен промышленный альпинист, а когда достаточно исполнителя со стремянкой, и как найти мойщика на сегодня-завтра без обзвона клининговых компаний.