- Покупатель приехал за заказом, но не нашёл вход: что проверить в карточке пункта самовывоза
Заказ уже оформлен, товар собран, а покупатель звонит с соседней улицы: «Я приехал, но вас здесь нет». Прежде чем менять рекламу, стоит проверить последнюю часть пути — от карточки на Картах до двери выдачи.
Это не история конкретного магазина, а практическая памятка для владельца розничной точки или пункта самовывоза.
1. Пройдите путь покупателя, а не сотрудника
Откройте публичную карточку на телефоне. Сверьте адрес и расположение организации с фактическим местом выдачи. Постройте маршрут из нескольких обычных точек прибытия: ближайшей остановки, парковки, соседней улицы. Затем пройдите последний участок пешком. Если маршрут заканчивается у служебных ворот, за забором или с другой стороны здания, зафиксируйте, где именно возникает ошибка. Верный почтовый адрес ещё не означает понятный путь к двери.
2. Уберите противоречия между тремя инструкциями
Сравните карточку, страницу самовывоза на сайте и сообщение о готовности заказа. Везде должны совпадать место выдачи, часы работы и понятные ориентиры. Отдельно проверьте вечер, выходные и доступ через территорию: открытые ворота днём не гарантируют вход после окончания работы соседнего предприятия.
Слов «вход со двора» бывает недостаточно. Лучше назвать заметный ориентир и показать реальную последовательность: фасад с вывеской, нужный проход, дверь. Используйте собственные актуальные фотографии без лиц посетителей и номеров заказов. Указывайте только настоящий, доступный покупателям вход; не создавайте фиктивные филиалы ради дополнительных отметок.
3. Проверьте результат после исправлений
Ошибку расположения или данных нужно исправлять через доступные инструменты сервиса, а не пытаться компенсировать выдуманным адресом. После обработки изменений снова откройте публичную карточку: отправленная правка не означает, что покупатель уже видит новые сведения. На сайте и в уведомлениях обновите инструкции отдельно.
Для контроля достаточно обезличенно отмечать обращения «не могу найти вход» и ошибки места выдачи за сопоставимые периоды. Не публикуйте имена, телефоны и детали заказов. Снижение таких обращений полезно оценивать вместе с количеством выдач: в спокойную неделю звонков может стать меньше просто из-за меньшего числа покупателей.
Такая проверка не обещает рост позиций или продаж. Её задача проще: убрать проверяемые препятствия между оформленным заказом и получением товара.
Материал подготовлен с помощью ИИ.
- Claude ставит на свои тексты невидимую метку: как она устроена и чем снимается
В середине лета Anthropic внесла изменение, которого не видно ни в интерфейсе, ни в самих ответах: тексты новых моделей Claude теперь несут метку. Дело не в подписи под текстом и не в скрытых символах, сигнал зашит в том, как модель подбирает слова. Скопируйте ответ в документ, перешлите в чат или выложите в блог, и метка поедет следом. Дальше — о том, что она собой представляет, кому открыта проверка и где границы доверия к ней.
Повод для свежего витка — облака. К 10 ноября раскатка маркировки завершится на Amazon Bedrock, так что она доберётся и до компаний, которые подключают Claude через облако.
Главное сразу
- Что метится. Любой текст, который выдают модели Claude, появившиеся после 2 августа 2026 года: в чате, через API, в Claude Code и в остальных продуктах. Более старые модели подключат позже.
- Как. Слова модель подбирает не совсем случайно: подсказку даёт секретный ключ. Ни невидимых символов, ни добавленных слов в тексте нет.
- Где. Везде в мире, хотя толчком стал европейский закон об ИИ. Ограничить метку одним регионом Anthropic, по своим же словам, пока не может.
- Кто проверяет. Детектор закрыт. Доступ по заявке выдают регуляторам, журналистам, исследователям, школам и вузам. У рядового пользователя способа проверить текст нет.
- Что стирает. Серьёзная правка, пересказ, перевод, смешение с чужим текстом. В коротком фрагменте сигнала почти не остаётся.
- Главная оговорка. Метка говорит, что текст прошёл через Claude, а не что Claude написал. Отсутствие метки тоже ничего не доказывает.
Метку ввели из-за закона
В ЕС работает закон об ИИ: статья 50 обязывает делать контент, созданный нейросетью, распознаваемым для машины. В августе заработал добровольный кодекс о прозрачности, где расписано, как этого добиваться. Под ним стоят подписи Anthropic, Google, Meta, Microsoft, OpenAI и ещё нескольких компаний.
О маркировке стало известно 10–11 августа. Сначала Anthropic выложила справку «Как Claude помечает созданный ИИ контент», а тремя днями позже — материал в блоге с разбором работы текстовой метки. Презентаций и шума не было, поэтому многие о ней так и не слышали.
Как из слов получается метка
Текст языковая модель собирает по фрагменту. Для каждого шага у неё заготовлен перечень продолжений с вероятностями: скажем, «быстро» 30 %, «легко» 25 %, «без труда» 20 % и так далее. Из этого перечня генератор случайных чисел берёт один вариант. Выбор при этом чаще всего действительно случаен.
Водяной знак эту случайность подменяет. Вместо обычного генератора в дело идёт секретный ключ и несколько предыдущих слов: по ним модель решает, каким вариантам отдать небольшое предпочтение. Смысл при этом сохраняется, выбор идёт из подходящих слов.
Зато на длинном тексте копится статистический перекос, которого случайно не бывает. Обладатель ключа его увидит, а без ключа текст ничем не отличается от обычного.
По словам Anthropic, в основе метки лежит подход SynthID-Text. Описала его Google DeepMind в журнале Nature в 2024 году и сразу открыла к нему доступ. Google проверила 20 млн ответов Gemini и не увидела, что помеченные варианты получают от пользователей худшие оценки. Anthropic утверждает то же: ни смысл, ни качество, ни удобство чтения ответа метка не меняет, а сторонних замеров на Claude пока не публиковали.
Устройство метки даёт две заметные детали:
- В фактах и коде след слабее. Если верный ответ один, менять не на что: дату, формулу или название функции синонимом без потери смысла не подменишь. Anthropic прямо признаёт, что во фрагментах с фактами и в коде знак слабее.
- Скрытых символов не появилось. Программа, счищающая пробелы нулевой ширины и другой скрытый мусор, метку не уберёт. Она сидит в самих словах.
Где метка есть, а где её нет
Метка ставится на уровне модели. Значит, она есть в любом продукте, где работает поддерживаемая модель: в приложении Claude, в API, в Claude Code, Cowork и Claude Tag. Если брать Claude через облака AWS, Google Cloud или Microsoft Foundry, текст уходит уже помеченным. На Bedrock раскатка закончится к 10 ноября.
Метка стоит на каждой модели, появившейся 2 августа 2026 года или позже. Старым моделям её обещают добавить позже, без конкретной даты. Оговорка тоже есть: на Sonnet 4.6 и Opus 4.6 метка иногда не срабатывает, если через API передать в запросе другую температуру или иные параметры выборки слов.
С файлами устроено иначе. Картинки, видео и аудио из песочницы Claude для кода получают метаданные с подписью по стандарту C2PA. Внутри файла остаётся запись: «создано или обработано Claude». Форматов много: PNG, JPEG, GIF, WebP, SVG, MP4, MP3 и другие. А PDF, текстовые и офисные документы подписи не получают вовсе.
Устроены C2PA-метаданные проще, чем текстовая метка, и стираются легче. Достаточно сменить формат картинки при пересохранении, сжать её заново или снять скриншот, и подпись пропадёт.
Кто может проверить
Для файлов есть открытый инструмент: Claude Content Checker на сайте claude.com. Он читает метаданные C2PA прямо в браузере, файл никуда не отправляется. Что до самого текста, его этот сервис не смотрит. А детектор, который ищет текстовую метку, для посторонних закрыт.
Anthropic называет его частной предварительной версией и пускает по заявке. В список тех, кому дают доступ, входят регуляторы, правоохранительные органы, СМИ и фактчекеры, независимые исследователи, учебные заведения, общественные организации в ЕС и фирмы, которые прогоняют через детектор свои же материалы, созданные в Claude. Расширить доступ обещают «со временем».
Чего Anthropic не публикует, так это цифр. Ни точность распознавания метки, ни доля ошибок на текстах, написанных людьми, ни объём, после которого ответ можно считать уверенным, не раскрыты. Справка ограничивается оговоркой: если фрагмент очень короткий, сигнала для надёжной проверки не хватит.
Что стирает метку
Копирование и вставку метка переживает, утверждает Anthropic, и «может сохраниться после некоторой правки». Надёжность она теряет, когда текст:
- сильно правили;
- пересказали своими словами;
- перевели на другой язык;
- смешали с другим текстом;
- сократили до пары предложений.
Причина простая: смещение накапливается по всему тексту, и любая переписанная фраза его разбавляет. А перевод подменяет весь словарь разом, так что от метки почти ничего не остаётся.
Как только о маркировке объявили, разработчики начали выкладывать инструменты для её обхода. По сообщению Wired от 19 августа, обходные утилиты пошли в течение нескольких часов после анонса, а одна собрала тысячи звёзд на GitHub. Работают ли они в реальности — никто сторонний не проверял. Невидимые символы, которых, как мы выяснили, в тексте Claude нет, вычищает лишь часть таких программ. Остальные переставляют предложения, подставляют синонимы и прогоняют текст через перевод. То есть делают то, что Anthropic и так перечислила как слабые места.
Выходит, под удар попадают те, кто забирает ответ целиком и ничего не правит. Тот, кто хочет её убрать, уберёт. Инструмент создан под массовый поток текста, а не против тех, кто целенаправленно обходит защиту.
Метка не означает авторство
Самое важное Anthropic пишет в справке без уверток: обнаружив метку, вы узнаёте лишь, что контент «мог быть создан или обработан Claude». И сигнал этот, по её словам, «не окончательный».
Обработка и авторство тут не одно и то же. Скажем, статью вы писали сами, а Claude попросили поправить запятые, сделать перевод или сократить. Тогда в правленом тексте окажутся помеченные фрагменты, и детектор их обнаружит. А автор при этом вы.
В обратную сторону это тоже работает. Отсутствие метки ещё не значит, что перед вами текст человека. Источником могла быть прежняя версия модели Claude, сторонняя нейросеть без маркировки либо открытая модель, никем не помеченная. Мог быть отредактирован или переведён.
У всего этого есть предыстория. The Wall Street Journal в 2024 году отмечал: похожая метка для ChatGPT у OpenAI появилась давно, однако включать её компания не стала. Причина среди прочего в опасении, что детектор начнёт несправедливо бить по тем, кто использует ChatGPT как редактора и для кого английский не родной. Сейчас к маркировке крупных разработчиков подтолкнул закон, а сама проблема никуда не делась.
Что из этого следует
Студентам и преподавателям. Доступ к детектору дают в том числе учебным заведениям. Однако уликой в списывании метка не служит: она появится и на работе, которую студент написал своими руками, а потом отдал Claude на проверку. Для преподавателя это скорее повод поговорить, чем готовый приговор.
Копирайтерам и авторам блогов. Ответ Claude, который вы выкладываете почти без правок, помечен. Удостовериться в этом сегодня способен лишь узкий круг организаций, хотя обещают, что доступ расширят. Ни площадки, ни поисковики пока не заявляли, что читают такую метку. Если у вас в работе схема «модель пишет, человек серьёзно переписывает», от метки уцелеет немного, и это честно показывает, как сделан текст.
Разработчикам. У кода вариантов меньше, поэтому и метка в нём слабее, чем в обычном тексте. Когда ваш продукт выдаёт пользователям тексты из Claude, они помечены. Кроме того, Anthropic советует самому разобраться, какие из требований статьи 50 относятся именно к вашему сервису. Обязанности того, кто встроил метку модели в свой продукт, она не отменяет.
Тем, кто работает с картинками. Проверить подпись C2PA можно бесплатно и без труда, однако любое пересохранение её сбрасывает. Отсутствие подписи у картинок ничего не говорит об их происхождении.
Что в остатке
Это подпись производителя, а не привычный детектор ИИ-текста. Неизменённый ответ модели она находит надёжно, а вот о судьбе текста, побывавшего у человека, в переводе или в другой нейросети, не сообщает ничего. Точность в цифрах не раскрыта, а проверить текст сегодня способен лишь узкий круг организаций.
Для рядового пользователя мало что меняется. Если выкладываете готовый ответ Claude как есть, считайте его подписанным. Когда модель служит вам редактором, переводчиком или собеседником на этапе черновика, метка способна обнаружиться и в тексте, написанном вами. Помнить об этом стоит обеим сторонам: и авторам, и тем, кому предстоит проверять.
- Нейросети среднего сегмента: GPT-6.1 Terra за $1, Haiku 5.5, DeepSeek и Kimi
Этот материал помогает сравнить четыре модели по цене, скорости и задачам, где они окупаются. Я сверил официальные тарифы и результаты тестов, затем оценил стоимость пяти типовых сценариев.
Весной выбор обычно сводился к двум вариантам: крупная модель для трудных задач или компактная для черновиков. В октябре между ними появился отдельный слой. OpenAI представила GPT-6.1 Terra для офисных задач и рутинных агентов. Moonshot выпустила Kimi K3.1 Pro: в программировании она почти достигла Claude Opus 5.5 при цене вдвое ниже. Haiku 5.5 и DeepSeek V4.1 Flash находятся ещё дешевле.
Собственных проверок качества здесь нет. Оценки взяты из материалов производителей, показатели скорости, у Artificial Analysis. Расход токенов для сценариев я оценил самостоятельно. У моделей разные токенизаторы, поэтому для русского текста реальная стоимость может отличаться на 10–30 %, но соотношение цен от этого не меняется.
Ключевые различия моделей
- GPT-6.1 Terra. Миллион входных токенов стоит $1, выходных, $5. У предыдущей Terra цены были $2 и $12. По тестам OpenAI она сопоставима с GPT-6 Astra, хотя последняя дороже в десять раз.
- Kimi K3.1 Pro. Тарифы составляют $2 и $10. Это наиболее дорогая и медленная модель в сравнении, но она сильнее остальных в коде. Веса планируют открыть до 4 ноября.
- Claude Haiku 5.5. Стоимость равна $0,10 за вход и $0,50 за выход. Модель отвечает быстрее других, однако при максимальном рассуждении может расходовать много токенов.
- DeepSeek V4.1 Flash. Ночью и по выходным цены равны $0,15 и $0,60, в пиковые часы они увеличиваются вдвое. Кэш стоит почти ничего, а веса доступны по лицензии MIT.
GPT-6.1 Terra стала дешевле прежней версии
Предыдущая Terra была последней моделью OpenAI поколения 5.6. Новая версия снизила цену входа с $2 до $1, а выхода, с $12 до $5. Миллион токенов повторяющейся части запроса из кэша обходится в $0,05. В пакетном режиме с ответом в течение суток цена остаётся вдвое ниже.
В задачах программирования эта модель не занимает первое место. При максимальном уровне рассуждения в Terminal-Bench 4.0, тесте задач для командной строки, Terra выполняет 50,3 %. Предшественница набирала 21,5 %. Для тяжёлого кода сама OpenAI рекомендует GPT-6.1 Sol либо GPT-6 Astra.
Зато в управлении компьютером, включая окна, формы и таблицы, Terra показывает 74,2 % в OSWorld 2.1. Именно такие сценарии компания выделяет для модели.
OpenAI также приводит данные по ошибкам в фактах на сложных вопросах. При максимальном рассуждении Terra ошибается в 4,3 % ответов, а на среднем уровне, в 10,1 %. Поэтому выбранный уровень рассуждения здесь существенно влияет на результат.
Есть и ограничения доступа. В обычном чате ChatGPT Terra отсутствует: она доступна через API, в ChatGPT Work и Codex. Когда вход превышает 272 тысяч токенов, весь запрос считают по удвоенному тарифу входа и с увеличением цены выхода в полтора раза.
Terminal-Bench показывает разрыв в коде, скорость меняет картину
Единого независимого теста со всеми четырьмя моделями мне найти не удалось. Ближе всего к такому сравнению Terminal-Bench 4.0: результаты по нему раскрывает каждый из производителей.
Kimi K3.1 Pro решает 65,7 % задач. Это почти соответствует 66,4 % у Opus 5.5, при цене вдвое меньше. У Terra результат равен 50,3 %, у DeepSeek, 42,3 %, у Haiku, 39,2 %.
Для DeepSeek есть существенная оговорка. Компания проводила замер через оболочку Claude Code, а на агентных тестах итог заметно зависит от используемой оболочки.
По скорости порядок другой. Artificial Analysis оценивает Haiku 5.5 примерно в 235 токенов в секунду, DeepSeek, примерно в 180, Terra, около 95, Kimi, лишь 31. Haiku подготовит ответ на 2 000 токенов приблизительно за девять секунд, а Kimi потребуется больше минуты.
У Kimi есть ускоренный вариант Highspeed. Он работает в 2–3 раза быстрее, но стоимость тоже возрастает вдвое: до $4 за вход и $20 за выход.
Moonshot отдельно проверяет частоту выдуманных фактов. В собственном тесте с поиском K3.1 Pro допускает ошибки в 8,3 % утверждений, тогда как DeepSeek V4.1 Flash, в 23,3 %. Это не независимая проверка, но разрыв заметный.
Пять сценариев показывают реальную стоимость
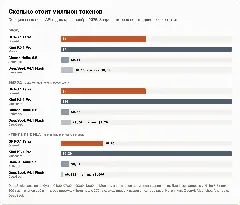
Расчёты ниже относятся к тысяче одинаковых запросов, кроме двух ресурсоёмких сценариев, где взята сотня задач. Токены рассуждений пока не учтены, они разобраны далее. Для DeepSeek используется ночной тариф, в пиковые часы все его суммы нужно умножить на два.
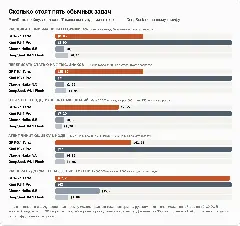
1. Категоризация писем. Инструкции вместе с письмом занимают примерно 800 токенов, ответ, около 30. Обработка тысячи писем обойдётся в $0,10 у Haiku, $0,14 у DeepSeek, $0,95 у Terra и $1,90 у Kimi. В таком сценарии платить за более сильные модели смысла нет.
2. Рерайт статьи на 7 тысяч знаков. На вход подаются 3 000 токенов текста и инструкции, на выходе получается 2 500. Тысяча статей стоит $1,55 у Haiku, $1,95 у DeepSeek, $15,50 у Terra и $31 у Kimi. Здесь разница касается уже качества результата, поэтому экономию лучше сначала проверить на собственных текстах.
3. Ответы поддержки по базе знаний. В кэше находится база размером 20 000 токенов, пользовательский вопрос занимает 300 токенов, ответ, 250. Самый дешёвый вариант, DeepSeek: $0,26 за тысячу ответов благодаря цене кэша $0,003 за миллион. Для Haiku сумма равна $0,36, для Terra, $2,55, для Kimi, $7,10. Кэш Kimi обходится в 67 раз дороже, чем у DeepSeek, и в этом сценарии это определяет итоговый счёт.
4. Агент исправляет ошибку в коде. На одну задачу приходится около 30 обращений: всего 1,5 млн входных токенов, 90 % которых берутся из кэша, и 40 тысяч выходных. Сотня задач стоит $4,85 на Haiku, $5,06 на DeepSeek, $41,75 на Terra и $97 на Kimi. Но слабая модель чаще не справляется, а повторный запуск требует и денег, и времени человека. В Terminal-Bench Kimi выполняет в 1,7 раза больше задач, чем Haiku.
5. Анализ документа на 300 тысяч токенов. При выходе в 3 000 токенов сотня документов стоит $4,68 на DeepSeek, $15,75 на Haiku, $62,25 на Terra и $63 на Kimi. После 100 тысяч токенов Haiku дорожает в пять раз. У Terra цена удваивается после 272 тысяч, а у DeepSeek и Kimi такого порога нет.
Стоимость задачи зависит не только от тарифа
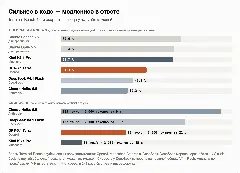
Тариф за миллион токенов не отражает, сколько токенов модель фактически израсходует. Artificial Analysis запускает модели на едином наборе задач и фиксирует расход. На максимальном рассуждении Haiku 5.5 выдала 300 млн токенов, Kimi, 110 млн, Terra, 99 млн.
Haiku стоит в десять раз меньше Terra за токен, но на сложных заданиях расходует втрое больше текста. Средняя задача из этого набора обошлась в $0,41 на Haiku, $0,96 на Terra и $3,68 на Kimi. Поэтому десятикратная разница в прайсе превращается примерно в двукратную.
В простых сценариях, например при сортировке писем, рассуждение не требуется, и преимущество Haiku сохраняется полностью. В сложных задачах его заметно уменьшает многословный ответ.
Для массовых простых операций уровень рассуждения лучше снижать или отключать. У Haiku 5.5 рассуждение включается по умолчанию, как и у DeepSeek.
Модели подходят для разных типов работы
- Массовые простые операции: Haiku 5.5. Подходит для сортировки, извлечения данных и коротких ответов. Это самая быстрая модель из четырёх, поэтому она удобна для чатов, где человек ждёт ответ сразу.
- Документы большого объёма и кэшированные базы: DeepSeek V4.1 Flash. Модель дешевле других при длинных входах и повторяющихся запросах. Тяжёлые задания лучше отправлять ночью или на выходных: в будние дни пиковые часы по Москве идут с 4 до 7 и с 9 до 13. Открытые веса позволяют развернуть её на своём сервере.
- Офисные и браузерные агенты: GPT-6.1 Terra. Подходит для форм, таблиц и регулярных действий в интерфейсах. На максимальном рассуждении она реже ошибается в фактах. Это удобный вариант для тех, кто уже использует OpenAI.
- Программирование и длительные агентные процессы: Kimi K3.1 Pro. По задачам кода она ближе остальных к Opus 5.5 и заметно дешевле. Из-за невысокой скорости модель больше подходит для фоновых процессов, чем для диалога в реальном времени.
Следующий шаг — проверить модели на собственных задачах
Средний сегмент разделился на две группы. Terra и Kimi стоят доллар-два за миллион токенов и берут задачи, которые полгода назад требовали флагманских моделей. Haiku и DeepSeek стоят на порядок дешевле и справляются с черновой работой.
На сложных задачах преимущество дешёвых моделей уменьшается: они могут тратить больше токенов и потребовать повторных запусков после неудачи. Практичная схема выглядит так: недорогая модель сортирует, извлекает данные и готовит материал, а средняя работает там, где ошибка обходится дорого.
Перед переносом серьёзного процесса на новую модель прогоните двадцать своих реальных задач. Сравните не только прайс, но и итоговый счёт.
- Как написать свою первую книгу: 7 шагов от идеи до рукописи
Многие годами мечтают написать книгу, но не знают, с чего начать. Одни ждут вдохновения, другие бесконечно переписывают первую главу, третьи боятся, что их текст никому не будет интересен. Расскажу, как пройти путь от идеи до законченной рукописи и избежать ошибок, которые мешают начинающим авторам.
Rabotaem!



0 active users