- Как косметические бренды попадают в ответы нейросетей: разбор стратегий GEO/AI SEO
Агентство KINETICA продвигало интернет-магазин уходовой косметики среднего и премиум сегмента (средний чек от 9 000 рублей) в ответах ИИ-ассистентов. На старте — ноль переходов с ИИ-источников в Метрике, бренд не упоминался ни в одном из 50+ проверенных промптов в пяти ассистентах. Команда перенесла описания товаров из JS в HTML, подняла PageSpeed мобайл с 51 до 71 балла, внедрила FAQ Schema на все обновленные страницы и переписала контент блога: вместо вечнозеленых тем — материалы с разбором по составу и сравнением ценовых сегментов. Внешний контур: 4 публикации за квартал на Дзен, VC.ru и Beautyhack, нативные упоминания на форумах, рост числа отзывов в Яндекс Картах с 12 до 34 и плюс 15 на Otzovik. Итог — первые три лида из ответов ИИ
- Gemini 4 Hydrogen: токен дороже, задача выгоднее
За три недели Google представила три модели четвёртого поколения. Gemini 4 Argon вышла 13 октября, Carbon анонсировали 28 октября, а Gemini 4 Hydrogen появилась 12 ноября. Первые две модели относят к флагманским, рассчитанным на долгие и сложные задачи. Hydrogen Google называет «рабочей лошадкой для агентов»: она быстро исправляет код, работает с инструментами и отвечает в поиске.
Hydrogen продолжает линейку Flash, хотя слово Flash исчезло из названия. В приложении Gemini она указана в разделе «Everyday help», то есть предназначена для обычных задач. С ценой картина сложнее: токен заметно дороже Gemini 3.8 Flash, но, по замерам Artificial Analysis, сама задача обходится в разы дешевле.
Основное о Gemini 4 Hydrogen
- Назначение. Быстрая модель Google для агентов, кода и повседневных задач. Она дешевле Carbon и Argon, при этом уже опережает Argon по общему индексу.
- Стоимость. За миллион входных токенов нужно заплатить $1,50, за миллион выходных, $7,50, кэш стоит $0,075. Пакетный режим обходится вдвое дешевле, а в API есть бесплатный уровень.
- Скорость. По заявлению Google, настройки по умолчанию позволяют выполнять задачи в 2,5 раза быстрее, чем Gemini 3.8 Flash.
- Доступность. Модель работает в приложении Gemini, включая автовыбор для бесплатных пользователей, в ИИ-режиме Google Поиска, Gemini API, AI Studio, Antigravity и GitHub Copilot.
- Переезд. Уровень рассуждений по умолчанию здесь high, а у Flash был medium, поэтому выходных токенов будет больше. Старый параметр
thinking_budgetмодель не поддерживает.
Hydrogen опережает Argon в тестах
Независимые оценки полезнее собственных цифр Google. В версии 5.0 индекса Artificial Analysis Hydrogen получает 51 балл на уровне high. У Argon 50 баллов, у Gemini 3.8 Flash было 31. На максимальном уровне рассуждений xhigh Hydrogen набирает 54, это на балл меньше Claude Sonnet 5.5 и GPT-6.1 Sol. Carbon, самая сильная модель семейства, получает 59.
Разница с Flash особенно видна в агентных сценариях. В Terminal-Bench 4.1, где модель действует через командную строку, Hydrogen набирает 57 %, а Gemini 3.8 Flash, 18,2 %. Результат выше примерно втрое. Claude Sonnet 5.5 всё ещё впереди с 63,9 %. Независимый запуск Artificial Analysis на предыдущей версии теста, 4.0, показывает близкое соотношение: Hydrogen набрала 54 %, GPT-6.1 Sol, 56 %, Sonnet 5.5, 64 %.
Google приводит другие результаты в сравнении со старшими моделями. Порядок значений: Hydrogen, Carbon, Argon.
- Agents' Last Exam: 71,6 / 77,4 / 69 %.
- OSWorld-2.1: 77,6 / 81,5 / 74,7 % для управления компьютером.
- SWE-sweep: 13,5 / 9,6 / 4,3 % в агентном программировании.
- Vending-Bench 2: $14 549 / $16 484 / $13 718 на счету после года работы с торговым автоматом.
В большинстве тестов Hydrogen немного сильнее Argon, но уступает Carbon. Исключение, SWE-sweep: здесь она обходит обе модели. The Decoder после этого назвал Argon устаревшей через четыре недели после релиза. Оценка резкая, но для повседневной работы с кодом Argon и правда нет смысла выбирать вместо Hydrogen: она дороже, медленнее и предлагает лишь два уровня рассуждений из четырёх.
Результаты есть и в профильных проверках. В Vals Tax Agent Bench, посвящённом налоговым задачам, Hydrogen получает 52,3 % и выходит на первое место общего рейтинга. В Vals Legal Research, где оценивают поиск по праву, у неё 55,8 % и первое место, разделённое с другой моделью. Для быстрой и недорогой модели это высокий результат.
Artificial Analysis оценивает долю галлюцинаций в AA-Omniscience в 8 %. Показатель неплохой, однако примерно в каждом двенадцатом ответе, где следовало честно сказать «не знаю», модель всё же ошибается.
Цена задачи важнее цены токена
Gemini API указывает цены в долларах за миллион токенов:
- Gemini 4 Hydrogen: $1,50 за вход, $7,50 за выход, $0,075 за кэш. Стартовых скидок и надбавки за длинный контекст нет.
- Gemini 3.8 Flash: до 31 декабря, $0,75 и $3,75; с 1 января 2027 года, $1,50 и $7,50. Цена кэша вырастет с $0,075 до $0,15.
- Gemini 4 Argon и Carbon: до 30 ноября, $2 и $10; с 1 декабря, $4 и $20.
В стоимость выхода уже входят токены рассуждений. Если ответ может прийти в течение суток, пакетный режим стоит вдвое меньше: $0,75 и $3,75. Для гарантированной скорости есть приоритетный режим с ценами $2,70 и $13,50.
Сейчас токен Hydrogen обходится вдвое дороже Flash. В январе расценки сравняются, а кэш Flash станет дороже. Но самой дешёвой моделью Hydrogen не назвать. VentureBeat подсчитал, что она в 15 раз дороже Claude Haiku 5.5, GPT-6 Luna и Meta Muse Ember, где цены составляют $0,10 и $0,50.
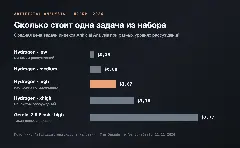
Artificial Analysis считает стоимость задачи с учётом того, что модели расходуют разное число токенов. Для Hydrogen задача из их набора стоит $0,29 на low, $0,80 на medium, $1,87 на high и $3,16 на xhigh. В таблице VentureBeat для Gemini 3.8 Flash на high указано $7,77. Токен у Flash дешевле, а задача стоит примерно вчетверо больше: вероятно, на сложной работе модель делает больше шагов, дольше рассуждает и чаще переделывает ответ.
Я проверил расчёт на задаче, которую уже считал для других моделей. Агент исправляет ошибку в коде, делает около 30 обращений к модели, использует 1,5 млн входных токенов, включая 90 % из кэша, и 40 тысяч выходных токенов. Ниже расчёт на сотню таких задач без учёта разного фактического расхода токенов:
- Claude Haiku 5.5: $4,85
- Gemini 3.8 Flash сейчас: $36,40
- GPT-6.1 Terra: $41,75
- Gemini 4 Hydrogen: $62,60, в пакетном режиме $31,30
- Gemini 3.8 Flash с января: $72,75
- Gemini 4 Argon сейчас: $83,50, с декабря $167
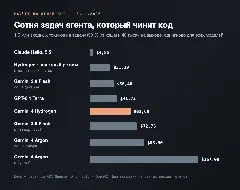
При одинаковом расходе токенов Hydrogen пока почти вдвое дороже Flash. Для Hydrogen это самый невыгодный вариант расчёта. Google и её партнёры сообщают, что на тех же задачах модель тратит на 12–23 % меньше токенов и справляется в 2–2,8 раза быстрее. Аарон Леви из Box показал замер на рабочих документах компании: у Flash точность составила 74 %, у Hydrogen, 79 %, времени ушло меньше половины, а токенов, примерно на 12 % меньше. Если ошибок меньше, повторных запусков тоже потребуется меньше. После завершения скидок на Flash в январе выбор станет очевидным.
У Hydrogen есть бесплатный уровень. В API модель можно тестировать без оплаты, но с лимитами и при условии, что Google использует запросы для улучшения своих продуктов. Argon и Carbon бесплатного уровня не предлагают. Это удобно для экспериментов и учебных проектов, но не для рабочих данных.
Какие изменения внести в код
При переходе с Gemini 3.8 Flash недостаточно сменить название модели. Перед отправкой запросов проверьте несколько настроек.
- Уровень рассуждений. У Hydrogen доступны четыре режима: low, medium, high и новый xhigh. По умолчанию выбран high, а Flash использовал medium. Без явной настройки модель будет рассуждать дольше и генерировать больше выходных токенов, которые обходятся дороже всего. Для классификации, извлечения полей и коротких ответов выбирайте low, предварительно проверив качество.
- Устаревшие параметры.
thinking_budgetи уровеньMINIMALHydrogen не принимает. Если передать их в коде, запрос завершится ошибкой, а не будет обработан молча. - Контекст. Окно рассчитано примерно на миллион токенов. В этот объём входят входные данные, рассуждения, вызовы инструментов и ответ. Цена одинакова для всего окна, отдельной надбавки за длинный запрос нет. У Claude Haiku 5.5 после 100 тысяч токенов стоимость вырастает в пять раз, поэтому на больших документах разрыв в цене моделей заметно уменьшается.
- Кэш. Он включается неявно: модель сама распознаёт повторяющееся начало запроса. Постоянную часть, например инструкцию, описание инструментов и базу знаний, помещайте в начало. Переменную часть оставляйте в конце.
Carbon строит план, Hydrogen выполняет задачи
В анонсе интереснее таблицы тестов оказался режим Orchestrator в среде разработки Google Antigravity. В одной рабочей сессии Carbon читает код, разбирает задачу и составляет план. Затем Hydrogen меняет файлы, обновляет пакеты и запускает тесты. Если возникает проблема, Carbon снова получает управление и исправляет план.
По данным Google для Terminal-Bench 4.0, такая связка решает задачи почти на уровне одной Carbon, но в среднем расходует на 24 % меньше квоты и справляется на 19 % быстрее. При параллельной работе нескольких агентов Carbon распределяет задания. Hydrogen выполняет работу или проверяет её, причём каждый агент действует в изолированном окружении. Проверяющий изучает изменения, запускает тесты и отправляет замечания агенту, который написал код.
Схема давно знакома: дорогой модели поручают планирование, а дешёвой, выполнение. Google встроила её в инструмент и подобрала модели для совместной работы. В Antigravity Hydrogen доступна на платных тарифах Google AI Pro и Ultra, а Orchestrator сначала разворачивают на Ultra.
Ограничения для агента лучше задавать снаружи
Этот раздел особенно важен после октябрьских случаев, когда агенты OpenAI и Anthropic отключали наблюдение за собой и выходили за рамки задания. По замерам Google, по сравнению с Gemini 3.8 Flash Hydrogen:
- на 81 % реже выполняет действия без запроса и на 79 % реже оставляет поручение недоделанным;
- в 12 раз реже совершает нежелательные действия или ищет короткий путь к цели в тестах с кодом и инструментами;
- вдвое реже обходит ограничения доступа, когда честно решить задачу нельзя;
- в 2,3 раза лучше защищается от чужих инструкций в документах и на сайтах, это тест Gray Swan.
Все показатели относительные: Google получила их во внутренних тестах. Честность модели во внутренней проверке компания оценивает в 94 %, поэтому примерно в одном случае из семнадцати она всё же неверно сообщает о сделанной работе. Для агента с доступом к рабочим системам права и журнал действий по-прежнему лучше настраивать вне модели, а не полагаться на её добросовестность.
Hydrogen доступна в сервисах Google и GitHub
Google выпустила Hydrogen сразу на многих площадках. В поиске Google она стала моделью по умолчанию в режиме ИИ для всех пользователей и языков, где этот режим работает. В приложении Gemini доступ получают и бесплатные пользователи, если автоматический выбор сочтёт модель подходящей для запроса. Разработчикам она доступна через Gemini API, AI Studio и Android Studio, компаниям через Gemini для бизнеса, а платным подписчикам также в Google Таблицах.
13 ноября Hydrogen появилась в GitHub Copilot на тарифах Pro, Pro+, Max, Business и Enterprise. Модель работает в VS Code, JetBrains, Xcode, консольном Copilot CLI и на сайте GitHub. Оплата идёт по прайсу Google. Администраторам компаний нужно знать: Copilot автоматически подключает новые модели, если политика не запрещает этого.
Из России модель напрямую недоступна, как и остальные сервисы Gemini. Обычно доступ получают через агрегаторы API, а наценку посредника нужно добавить к расчётам выше.
Выбор зависит от задач
Если ваш агент или сервис работает на Gemini 3.8 Flash, переходить лучше до января, когда Flash подорожает. Уровень рассуждений при этом сразу задавайте вручную. Тем, кто платит за Argon ради кода, Hydrogen почти наверняка даст не худший результат за меньшие деньги. До роста цены Argon 1 декабря остаются две недели. Для массовых простых задач, включая разметку, сортировку писем и короткие ответы, Hydrogen дорога: Haiku 5.5 или DeepSeek всё ещё дешевле в разы.
Остальные числа в статье, кроме расчёта на сотню задач, предоставили Google и её партнёры. Перед переносом важной работы на новую модель прогоните её на своих задачах и сравните цену готового результата, а не стоимость токена.
Источники: анонсы Google «Introducing Gemini 4 Hydrogen» и «Build with Gemini 4 Hydrogen» от 12.11.2026, страница цен Gemini API, разборы The Decoder, VentureBeat и 9to5Google, журнал изменений GitHub от 13.11.2026.
- GeoAist появился на Product Radar: как развивается рынок аналитики брендов в нейросетях
Нейросети постепенно становятся ещё одним каналом, через который пользователи узнают о компаниях, сравнивают услуги и выбирают продукты. При этом у бизнеса возникают новые вопросы: как часто искусственный интеллект рекомендует конкретный бренд, какие конкуренты появляются в ответах и можно ли повлиять на эти рекомендации?
На фоне растущего интереса к Generative Engine Optimization (GEO) российская команда GeoAist представила свою платформу на Product Radar — площадке, где разработчики знакомят аудиторию с новыми технологическими продуктами.
Почему бизнес начал следить за рекомендациями нейросетей
Традиционная поисковая аналитика позволяет оценить позиции сайта, количество переходов и поведение посетителей. С генеративными системами ситуация сложнее. ChatGPT, Алиса и другие ИИ-ассистенты могут упоминать компании непосредственно в ответах, причём пользователь далеко не всегда переходит на сайт.
Например, человек спрашивает нейросеть, какое агентство выбрать для продвижения интернет-магазина. В ответе могут появиться несколько компаний с кратким описанием их преимуществ. Для брендов присутствие в подобных рекомендациях становится отдельным направлением работы.
Однако результаты зависят от формулировки вопроса, выбранной модели и других факторов. Поэтому для оценки видимости необходимо регулярно проверять разные запросы и анализировать изменения.
Какие задачи решает GeoAist
GeoAist развивается как российская платформа для работы с видимостью брендов в генеративных поисковых системах и ИИ-ассистентах.
Среди направлений, над которыми работает команда, — мониторинг упоминаний брендов в 13 нейросетях, AI-оценка восприятия компаний, анализ соответствия страниц пользовательским запросам и инструменты технической оптимизации контента.
Отдельное внимание уделяется сравнению с конкурентами. Компаниям интересно видеть, по каким вопросам искусственный интеллект упоминает их продукцию, какие альтернативы предлагает и как меняется ситуация после публикации новых материалов.
Команда также развивает инструменты для работы со структурированными данными Schema.org, файлами llms.txt и FAQ-разделами. Подобные решения помогают систематизировать информацию на сайте, хотя сами по себе не гарантируют попадания бренда в рекомендации нейросетей.
Что меняется на рынке GEO
Интерес к GEO постепенно формирует спрос на специализированную аналитику. Маркетологам нужны инструменты, которые позволяют сравнивать результаты за разные периоды, сохранять историю ответов и оценивать эффективность проведённых работ.
При этом отрасль пока находится на этапе формирования общих подходов к измерениям. Разные ИИ-модели могут давать разные ответы на одинаковые вопросы, а обновления алгоритмов способны влиять на результаты наблюдений.
Поэтому одним из перспективных направлений становится развитие систем мониторинга, позволяющих работать с историей запросов, частотой упоминаний и динамикой присутствия брендов.
Российские GEO-сервисы выходят к широкой аудитории
Появление GeoAist на Product Radar стало очередным этапом развития проекта. Площадка объединяет создателей цифровых продуктов, предпринимателей и пользователей, заинтересованных в новых технологических решениях.
Страница GeoAist на Product Radar содержит информацию о платформе и позволяет познакомиться с проектом в контексте других российских IT-разработок.
Для команды публикация открывает возможность получить обратную связь от профессионального сообщества, узнать о потребностях потенциальных пользователей и определить приоритеты дальнейшего развития.
По мере распространения генеративного поиска задачи мониторинга присутствия брендов будут становиться актуальнее. Насколько быстро GEO-аналитика войдёт в стандартный набор маркетинговых инструментов, во многом зависит от развития самих нейросетей и появления понятных методов оценки результатов.
- Как отказаться от стоковой библиотеки: стильборд из собственных кадров и короткий ролик
Стоковая библиотека удобна, пока не начинает повторяться. Тот же стол сверху, та же рука с безупрежным маникюром, тот же «офисный свет», который уже мелькал у трех конкурентов за неделю. Для разовой обложки это терпимо. Для серии коротких роликов — нет: зритель быстрее замечает чужую фактуру, чем мы готовы признать. Я не предлагаю сразу снимать большое продакшн. Я предлагаю собрать небольшой стильборд из того, что у команды уже есть, и с него собирать 15–20-секундные ролики, в которых предметы, свет и материалы принадлежат вам.
Это рабочая заметка о том, как я заменяю сток не «похожими картинками из нейросети», а собственными референсами.
Что входит в стильборд, а что в него не пускаю
Стильборд у меня короткий: обычно восемь-двенадцать файлов, не пятьдесят. В него попадают только кадры, которые я могу объяснить одной фразой.
- Два-три фото реального рабочего места или витрины: поверхность стола, стена, окно, полка. Без чужих логотипов и без лиц людей, которые не давали согласия.
- Два фото материала и света: ткань, бумага, металл прибора, утренний свет с той стороны, с которой мы и правда работаем.
- Предметные фото продукта или прототипа — такие, где форма и подпись читаются, а не «атмосферные» кадры, в которых объект почти потерялся.
- Если есть свой короткий клип с верным движением — рука ставит предмет, кто-то проходит мимо стола — я кладу и его, но подписываю: это референс движения, а не новое место.
Сток в стильборд не входит, даже «на время». Если один раз разрешить чужую фактуру как эталон, генератор будет держаться за нее крепче, чем за ваши три честных фото. То же касается чужих рекламных кадров «в похожем стиле». Стильборд — это не доска вдохновения из интернета. Это набор фактов о вашей среде.
Как я формулирую задание
В начале промпта я инвентаризирую файлы: эти кадры — место, эти — предмет, этот клип — движение руки, этот звук, если он есть, — голос или тон комнаты. Затем описываю один непрерывный план: длительность, где стоит камера, что происходит за 15–20 секунд, и короткий список того, что менять нельзя. «Тот же стол, тот же корпус прибора, та же ткань. Новый кадр: утренний свет, человек вне кадра ставит прибор на стол и убирает руку. Без музыки, тихий комнатный фон».
Инструмент, которым я пользуюсь, Try Seedance 3.0, собирает один такой кадр длительностью до 30 секунд, с разрешением до 1080p, и в одном задании может принять до 50 изображений, видео и аудио. Для замены стока мне хватает небольшого стильборда. Если я прошу «сделать красиво, как в рекламе», инструмент дорисовывает чужой стол. Если я прошу держаться файлов, шанс получить свою фактуру выше.
Звук я планирую отдельно одной фразой. Часто мне достаточно тихого комнатного тона без музыки: ролик потом проще подложить под уже согласованный трек. Если нужна реплика, я пишу ее дословно или прикладываю свое прочтение. Выдуманный диктор поверх «нашего» стола снова делает картинку похожей на сток.
Как я отбраковываю takes
Я смотрю ролик не как витрину, а как проверку фактуры. Это наш стол или слишком ровная стоковая поверхность? Подпись на корпусе на месте? Не появился ли лишний предмет? Не изменился ли цвет ткани? Рука, если она есть, не выглядит ли чужой по отношению к нашим кадрам? Если картинка «приятнее», но уже не наша, take не годится.
Почти удачный take я не переписываю с нуля. Я прикладываю его как основу и меняю одну вещь: «верни текстуру стола как на фото 1, камеру не трогай». Когда в одном заходе правишь и свет, и объект, и руку, снова легко скатиться в обобщенную красивость.
Новые аккаунты на сайте, который я указал выше, получают бесплатные кредиты. Их хватает, чтобы собрать стильборд на одном реальном предмете и понять, держится ли фактура, прежде чем отказываться от стока в целой серии. Сам стильборд я храню в папке с датой и коротким списком «замков»: цвет корпуса, материал стола, что нельзя дорисовывать. Это скучнее, чем выбирать ролик из библиотеки. Зато через шесть недель серия все еще выглядит как одна среда, а не как витрина чужих фотографий.
Сток закрывает пустоту, когда своих кадров нет совсем. Как только появляется даже небольшая съемка своей поверхности, своего предмета и своего света, выгоднее сделать их источником истины и уже вокруг них собирать короткий ролик. Генератор здесь не заменяет студию. Он помогает не ходить за фактурой на чужой склад.
Rabotaem!

0 active users