Метод машинного обучения под названием CheMeleon предоставляет практический способ разработки новых лекарств или других молекул с гораздо меньшим количеством детальных и дорогостоящих экспериментов.
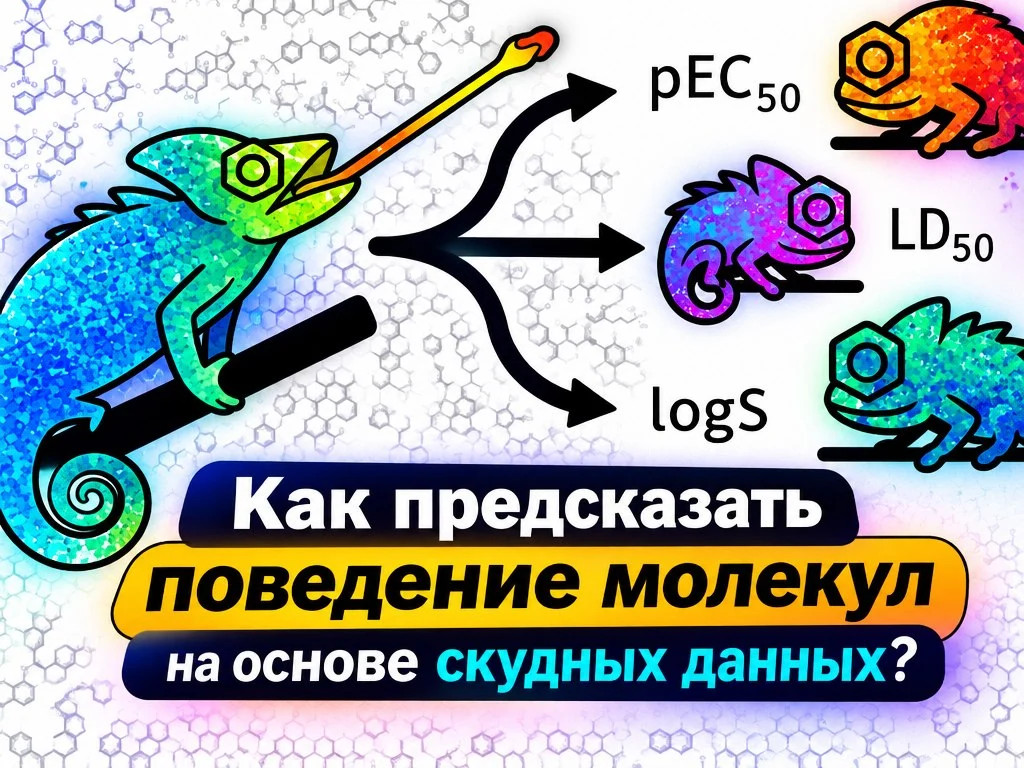
*Фото создано новой моделью gpt-image-2 через сервис от KolerskyAI
Открытие новых молекул для конкретных целей является одним из главных двигателей прогресса в самых разных отраслях, будь то фармацевтические компании, ищущие новые лекарства, или компании, занимающиеся электроникой или энергетикой, стремящиеся получить новые материалы с определенными свойствами. Но это также во многом процесс проб и ошибок, поскольку пока нет способа точно предсказать, как будет вести себя данное химическое соединение с точки зрения множества различных свойств и реакций, которые могут проявлять материалы.
В последнее время достигнут прогресс в использовании искусственного интеллекта и машинного обучения для дополнения или ускорения трудоемких вычислений, основанных на физических принципах, которые, по крайней мере, могут дать первоначальное представление о том, какие соединения стоит синтезировать и тестировать. Теперь новый метод, разработанный в Массачусетском технологическом институте, показывает, что при наличии небольшого количества данных о каком-либо технологически важном свойстве, таком как сродство лигандов к недавно обнаруженной клеточной мишени для потенциального лекарственного препарата, этот подход может превзойти другие существующие методы сужения круга возможных молекул, которые могут быть интересны для изучения.
Результаты исследования были опубликованы в номере журнала Journal of Chemical Information and Modeling от 14 сентября в статье аспиранта Массачусетского технологического института Акшата Шириша Залте и недавнего выпускника Джексона Бернса (PhD '26), научного сотрудника Шарлье Абреу, профессора Уильяма Грина и трех исследователей из химической компании BASF.
Более ранняя версия статьи была опубликована в сети еще в прошлом году, а разработанная командой модель с открытым исходным кодом, получившая название CheMeleon, уже регулярно используется несколькими фармацевтическими компаниями. CheMeleon был создан с использованием ChemProp, пакета машинного обучения с открытым исходным кодом, также разработанного и поддерживаемого группой Грина в Массачусетском технологическом институте, и любой желающий может загрузить CheMeleon через ChemProp и доработать его для своих целей.
Ранее в этом году OpenADMET организовал конкурс, целью которого было предсказание свойств различных новых молекул, ранее не синтезированных, — говорит Грин, профессор химической инженерии имени Хойта Хоттела. «Это был масштабный конкурс, в нем участвовало много людей», — говорит он. Когда были объявлены победители, выяснилось, что девять из 20 лучших работ использовали CheMeleon в своем процессе. «Поэтому мы начали получать всевозможные запросы от фармацевтических компаний по этому поводу, но наша статья только что была отправлена на рецензирование; она еще даже не прошла рецензирование».
Пока статья проходила процесс рецензирования, ее влияние уже распространялось. По словам Грина, по крайней мере одна фармацевтическая компания «разослала всем своим сотрудникам сообщение: „При моделировании любых свойств начинайте с CheMeleon, это наша новая политика компании“» при принятии первоначальных решений о том, какие молекулы следует исследовать.
Ключ к успеху CheMeleon заключался в предварительном обучении модели машинного обучения с использованием подробных данных о миллионе различных молекул, чтобы она могла изучить корреляции между структурой данной молекулы и ее поведением относительно каталога из примерно 1600 дескрипторов, разработанных химиками за десятилетия. Затем CheMeleon можно точно настроить для прогнозирования как хорошо известных свойств, таких как растворимость и вязкость, так и более экзотических свойств, таких как биоактивность или реакционная способность, в отношении определенного белка или фермента.
Эти миллионы молекул — ничтожно малая часть бесчисленных способов соединения атомов, но они предоставляют достаточно примеров, чтобы после обучения системы искусственного интеллекта на них она могла самостоятельно выявлять множество скрытых закономерностей и взаимосвязей, а затем применять их к новой, неизвестной молекуле, которая ей будет представлена.
«Большинство современных моделей глубокого обучения требуют больше данных, чем традиционные методы», — говорит Залте. По его словам, некоторые успешные модели используют обширные данные из опубликованной литературы в химических журналах. «Мы вообще не обращаемся к литературе. Мы просто вычисляем ряд молекулярных дескрипторов, таких как молекулярная масса или количество атомов кислорода, и другие». Затем прогнозирование этих дескрипторов составляет основу для их предварительного обучения.
CheMeleon — это предварительно обученная базовая модель. Вдохновленная известными базовыми моделями на таких языках программирования, как ChatGPT и Claide, которые, по сути, разрабатываются путем ввода огромного количества информации из интернета, CheMeleon использует молекулярные дескрипторы миллиона молекул из PubChem, крупной, свободно доступной базы данных химической информации, поддерживаемой Национальными институтами здравоохранения США.
В классических моделях, управляемых экспертами, специалисты в определенной области вручную вводят подробные знания о предмете исследования. При разработке этих классических моделей, по его словам, например, люди из экспериментов знают, что определенное интересующее свойство, скажем, растворимость, может быть связано с конкретными дескрипторами тех же молекул, «такими как молекулярная масса, количество присутствующих атомов кислорода или степень разветвленности или громоздкости молекулы».
Благодаря подходу этой команды, они могут начать с существующей архитектуры нейронной сети и обучить ее основам. «Мы обучаем ее не для конкретного свойства, а как общую модель, которая понимает определенный уровень химии, так что даже если вы доработаете ее, используя всего несколько точек данных для интересующей вас задачи, вы все равно сможете получить неплохие результаты», — говорит он. Это стало возможным благодаря тому, что модели «не нужно учиться всему с нуля».
Чтобы подтвердить свою полезность, «мы сравнили нашу модель не только с другими существующими базовыми моделями, но и с классическими моделями, использующими принципы, разработанные экспертами», — говорит Залте. Сравнив ее производительность в 58 тестовых случаях, «мы видим, что наша модель превосходит остальные».
Грин добавляет: «Основная модель CheMeleon значительно сокращает количество молекул, которые необходимо экспериментально тестировать для точного прогнозирования свойств новых молекул. Это огромное преимущество, поскольку синтез и тестирование большого количества молекул — медленный и дорогостоящий процесс».
Помимо сотрудников MIT, в состав команды также входили Йохен Зиг, Кристиан Фельдман и Мириам Матеа, исследователи из BASF SE в Германии. Работа была поддержана консорциумом «Машинное обучение для открытия и синтеза фармацевтических препаратов», а также стипендиальной поддержкой Министерства энергетики США и компании MathWorks.
KolerskyAI